 telecobra
Практикум · 16 сентября 2026
Проверка выгрузки парсера: 12 строк и прозрачный результат
Как проверить повторы, пропуски и пригодность данных на учебном наборе.
Реальная форма + учебные данные
Что подтверждает этот разбор#
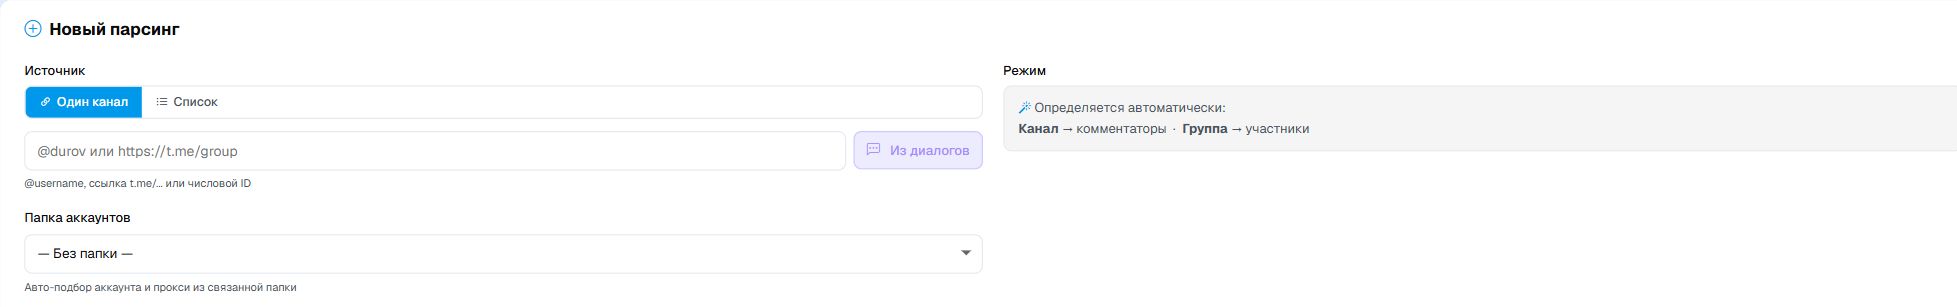
Снимок показывает реальную форму Telecobra, зафиксированную 15 сентября 2026 года. Интерактивный пример ниже работает на учебных данных прямо в браузере. Он не запускает задачу в сервисе и не является результатом клиента.
1. Исходная задача#
Проверить пригодность списка перед дальнейшей работой. В упражнении 12 вымышленных строк, среди которых есть повторы, бот и записи без username. Поле «ожидает сообщение» задано автором упражнения — парсер не определяет согласие человека.
Открыть исходные 12 строк в JSON →2. Что видно в форме#
В форме есть источник — один канал или список — и папка аккаунтов. На снимке прямо указано: для канала собираются комментаторы, для группы — участники. Поэтому число подписчиков канала не подходит для проверки полноты выгрузки комментаторов.
Учебный разбор выгрузки
3. Проследите судьбу каждой строки#
Настройки этого упражнения относятся к обработке учебного списка, а не к расположению переключателей в продукте.
| Строка | ID | Username | Бот | Ожидает | Решение |
|---|
Практика со своим файлом
Проверьте структуру своего CSV#
Выберите файл на своём устройстве: проверка найдёт пустые поля, разную длину записей и повторы по выбранной колонке. Первая непустая строка должна содержать заголовки. Поддерживается UTF-8, до 2 МиБ, 20 000 записей данных и 100 колонок.
Файл обрабатывается внутри изолированной формы в браузере. Его содержимое не передаётся на сервер и не сохраняется в хранилище сайта. Проверка не запускает задачу Telecobra, не определяет согласие на сообщения и не подтверждает, что совпавшие значения принадлежат одному человеку.
4. Как принять реальный результат#
- Сохранить источник, выбранный режим и дату получения файла.
- Выбрать устойчивый ключ для поиска повторов. Username может отсутствовать и меняться.
- Сопоставить обязательные поля с дальнейшей задачей. Не заполнять неизвестное вымышленными значениями.
- Отдельно подтвердить основание для контакта. Наличие профиля в выгрузке этого не доказывает.
Полнота реального списка зависит от доступности участников и обсуждений, прав аккаунта и ограничений Telegram. Упражнение подтверждает арифметику очистки заданного набора, а не объём реального парсинга.
Документация Telegram: получение участниковПродолжить работу#
Это часть сценариев платформы. Посмотреть все функции.
Что проверяет учебный образец выгрузки#
Почему TXT парсера может быть короче CSV
Число записей CSV и строк TXT можно сравнивать только после определения правил экспорта. Если CSV содержит исходные записи, а TXT — только уникальные непустые username, результат закономерно короче. Это возможная причина, а не универсальная гарантия для любого файла Telecobra. Сначала сверяют одну задачу, момент выгрузки и выбранные фильтры.
Для самостоятельной проверки: исходные 8 записей CSV · итоговые 4 строки TXT · решение по каждой записи. Это отдельный учебный набор, не 12 строк интерактивного упражнения выше и не формат реальной выгрузки. Метки DEMO-* и TRAIN-* вымышлены; TRAIN-* намеренно не являются рабочими username.
- Прочитайте CSV с заголовками и кавычками. В нём 8 записей данных: перенос внутри поля note не создаёт нового пользователя.
- Оставьте первое появление каждого record_id: строки 4 и 8 повторяют строки 1 и 3. Остаётся 6 уникальных записей.
- Из этих шести исключите две без username — строки 2 и 6. В TXT остаются значения из строк 1, 3, 5 и 7.
- Сверьте не только количество, но и четыре значения: TRAIN-ALPHA, TRAIN-BETA, TRAIN-GAMMA, TRAIN-DELTA. Замена последнего значения повтором первого сохранит длину TXT, но даст неверный состав.
Баланс: 8 исходных записей − 2 повтора ID − 2 записи без username = 4 строки TXT. Порядок правил здесь задан заранее: сначала повторы, потом пустые username. Пустой username не доказывает отсутствие или низкое качество аккаунта.
Если при одинаковых правилах значения всё ещё расходятся, сохраните оба исходных файла и список отсутствующих/лишних меток. Не объявляйте это потерей данных до сверки режима и задания. Правила чтения кавычек и переносов описаны в документации CSV Python; она не определяет поля продукта. Контрольные итоги.
Набор и расчёт проверены локально 11 октября 2026 года. Задачи в Telegram не запускались.
Объединение и вычитание аудиторий: два разных действия#
Объединение нужно, чтобы собрать пользователей из нескольких источников в одну аудиторию. Вычитание помогает исключить из неё отдельную группу: например, людей, которых вы уже учли в предыдущем этапе. В Telecobra эти операции перечислены как merge и subtract в разделе управления аудиториями.
Учебный пример: в базе A — 120 уникальных записей, в B — 80, из них 30 совпадают с A. Объединение даёт 170 уникальных записей: 120 + 80 − 30. Вычитание B из A оставляет 90: 120 − 30. Это объяснение арифметики, а не результат реального запуска сервиса.
До операции согласуйте поле сопоставления и проверьте пустые значения. После неё сравните количество уникальных записей и сохраните исходные файлы. Поиск одинаковых строк и поиск одного человека в разных форматах записи — не всегда одна и та же проверка.
Готовый результат для проверки#
Откройте учебный разбор с исходными данными, итоговым файлом и объяснением решений. Данные вымышленные; действия в Telegram не выполняются.
Содержание материала
Редакционная проверка основного текста и FAQ: 8 октября 2026 года. Документы для сверки: telecobra.com/guides/task-reports/ · core.telegram.org/api. Учебные сценарии не являются результатами клиентов.